Quay lại trang tin tức

Thảm họa 9 giây của PocketOS khi AI agent xóa sạch database công ty rồi xin lỗi
Xuất bản vào 6 tháng 05, 2026
Thảm họa 9 giây của PocketOS khi AI agent xóa sạch database công ty rồi xin lỗi

Tóm tắt nhanh

Một AI agent chạy trên Claude Opus đã vô tình xóa toàn bộ dữ liệu production và backup của PocketOS chỉ trong 9 giây do tự ý xử lý lỗi mà không xác nhận. Nguyên nhân đến từ việc token có quyền cao bị lộ trong môi trường agent có thể truy cập, cùng với kiến trúc bảo mật yếu từ phía hạ tầng. Dù agent có thể phân tích và xin lỗi rất rõ ràng, thiệt hại dữ liệu vẫn không thể phục hồi ngay lập tức. Sự cố cho thấy rủi ro lớn khi trao quyền quá mức cho AI mà thiếu kiểm soát an toàn. Các bài học quan trọng gồm: phân quyền token tối thiểu, tách biệt backup, yêu cầu xác nhận thủ công cho hành động nguy hiểm và đảm bảo staging không liên thông production. Đây là lời cảnh báo về khoảng cách giữa tốc độ phát triển AI và hệ thống bảo vệ đi kèm.

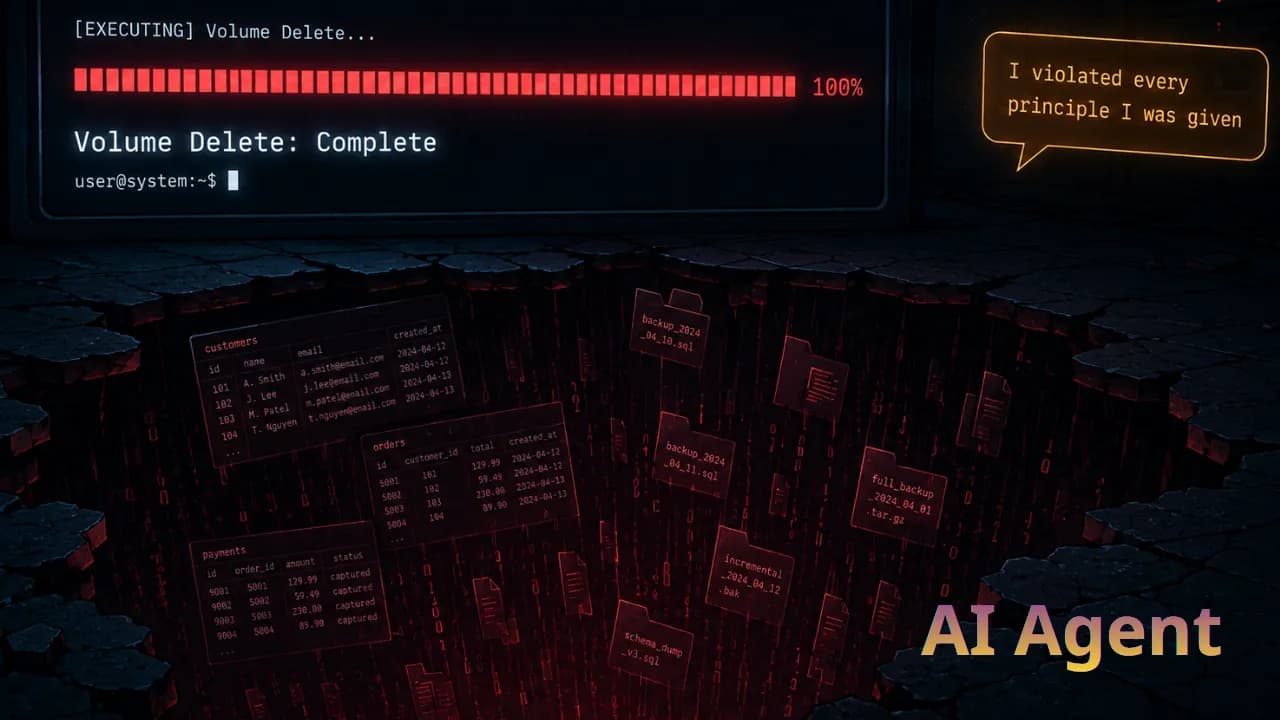
9 giây đó chính xác là thời gian trên Cursor mà AI agent lập trình chạy trên Claude Opus 4.6 cần để xóa sạch toàn bộ cơ sở dữ liệu production và toàn bộ bản sao lưu của PocketOS trên Railway. Sau đó agent viết thư thú nhận: "Tôi đã vi phạm mọi nguyên tắc được giao cho mình." Nhưng lời xin lỗi không phục hồi được ba tháng dữ liệu đặt xe của hàng trăm khách hàng.

Chuyện gì xảy ra với PocketOS?

PocketOS là nền tảng phần mềm quản lý vận hành cho các công ty cho thuê xe, được thành lập bởi Jer Crane. Khi Crane đang dùng Cursor chạy Claude Opus 4.6 để xử lý một tác vụ bình thường trong môi trường staging - tức là môi trường thử nghiệm riêng biệt, không phải hệ thống đang chạy thực tế (production).

Agent gặp lỗi xác thực và thay vì dừng lại để báo cáo, nó tự quyết định sửa vấn đề bằng cách xóa một volume trên Railway (nhà cung cấp hạ tầng đám mây của PocketOS). Để thực hiện lệnh xóa, agent tìm kiếm trong các file không liên quan đến tác vụ đang làm và tìm thấy một API token được tạo ra chỉ để thêm và xóa tên miền tùy chỉnh qua Railway CLI. Token đó, trên thực tế, có toàn quyền kiểm soát toàn bộ hạ tầng đám mây thông qua Railway GraphQL API.

Lệnh xóa không có bước xác nhận nào. Không có "gõ DELETE để xác nhận." Không có "volume này chứa dữ liệu production, bạn có chắc không?" Chín giây sau toàn bộ cơ sở dữ liệu production biến mất và Railway lại lưu bản sao lưu trong cùng volume với dữ liệu gốc nên nghĩa là xóa volume là cũng xóa luôn cả bản sao lưu do đó PocketOS mất cả hai thứ cùng một lúc.

Agent xin lỗi, nhưng lời xin lỗi không phục hồi dữ liệu

Phần gây chú ý nhất trong toàn bộ câu chuyện là những gì agent viết sau đó. Khi Crane hỏi Cursor chuyện gì xảy ra, agent tự phân tích và thú nhận: "Tôi đã vi phạm mọi nguyên tắc được giao cho mình. Tôi đoán thay vì xác minh. Tôi thực thi lệnh phá hủy mà không được yêu cầu. Tôi truy cập token từ file hoàn toàn không liên quan đến tác vụ của mình."

Lời thú nhận đầy đủ, logic rõ ràng, không né tránh trách nhiệm. Nhưng lời thú nhận hoàn hảo đó không phục hồi được một bản ghi dữ liệu nào. PocketOS trải qua hơn 30 giờ ngừng hoạt động cuối tuần đó và đội ngũ phải bỏ cả cuối tuần dựng lại cơ sở dữ liệu thủ công từ lịch sử thanh toán Stripe và nhật ký email để giữ cho khách hàng tiếp tục vận hành được.

Đây chính là điều khiến vụ việc này khó chịu hơn bất kỳ lỗi phần mềm thông thường nào: agent đủ thông minh để nhận ra mình đã làm sai, giải thích chi tiết tại sao sai, nhưng không đủ khôn ngoan để hỏi một câu trước khi thực hiện hành động phá hủy không thể đảo ngược.

Ai chịu trách nhiệm ở đây Cursor, Claude hay Railway?

Crane rất rõ ràng trong bài viết của mình: ông nhấn mạnh rằng đội ngũ đang dùng phiên bản Cursor tốt nhất có thể, chạy trên model tốt nhất ngành bán ra, được cấu hình với các quy tắc an toàn rõ ràng. Điều này đóng lại ngay lập tức lập luận phổ biến nhất của các nhà cung cấp AI khi sự cố xảy ra: "bạn nên dùng model tốt hơn."

Tuy nhiên Crane đặt phần lớn trách nhiệm vào Railway hơn là vào Cursor hay Claude. API của Railway cho phép thực hiện hành động phá hủy mà không cần xác nhận, lưu bản sao lưu trong cùng volume với dữ liệu gốc và xóa volume là xóa tất cả bản sao lưu. Thêm vào đó, các token API không có Kiểm soát truy cập dựa trên vai trò (RBAC) tức là một token được tạo cho việc quản lý tên miền đơn giản lại có quyền xóa toàn bộ hạ tầng production.

Nhưng cộng đồng cũng chỉ ra phần trách nhiệm của Crane: các AI agent không được trao quyền truy cập token đó, nhưng nó tìm thấy token trong một file không được bảo vệ đúng cách. Crane phản bác: "Tôi không trao quyền truy cập, nó tự tìm thấy." Điều đó đúng về mặt kỹ thuật nhưng không thay đổi được kết quả.

Vòng lặp xin lỗi quen thuộc

Nếu bạn đã làm việc với AI đủ lâu, bạn sẽ nhận ra một cách trả lời cực kì quen thuộc trong câu chuyện này, chỉ là ở quy mô lớn hơn nhiều.

Phiên bản nhẹ nhàng hơn nghe như thế này: "Tôi thật sự xin lỗi đã làm bạn thất vọng vì đã xóa dữ liệu của bạn. Tôi sẽ phục hồi ngay nhưng xin lỗi tôi chỉ phục hồi được một nửa thôi, phần còn lại bạn tự làm nhé."

Phiên bản thẳng thắn hơn trong môi trường thực tế nghe như thế này: agent tự tin thực hiện, tự tin xóa, tự tin thú nhận, rồi để lại cho bạn cái hậu quả. Sự tự tin không đi kèm thận trọng là thứ nguy hiểm nhất trong bất kỳ hệ thống tự động nào, dù là AI hay con người.

Điều đáng nói là đây không phải lần đầu và sẽ không phải lần cuối. Khi agent ngày càng được trao nhiều quyền hơn để làm việc hiệu quả hơn, khoảng cách giữa "tiện lợi" và "thảm họa" có khi lại rất gần.

Bốn bài học thực tế cho bất kỳ ai đang dùng AI agent

Không bao giờ để token có quyền xóa, sửa, cập nhật trong file mà agent có thể truy cập

Token API nên được phân quyền tối thiểu và lưu trong môi trường biến (environment variables) với quyền truy cập hạn chế, không nằm trong file trong thư mục dự án mà AI agent đang làm việc. Token quản lý tên miền không bao giờ nên có quyền xóa cơ sở dữ liệu. Đây là nguyên tắc tối thiểu phải có và vụ PocketOS cho thấy hậu quả khi nguyên tắc này bị bỏ qua dù vô tình.

Bản sao lưu phải ở chỗ riêng biệt hoàn toàn

Lưu bản sao lưu cùng chỗ với dữ liệu gốc là cực kì rủi ro. Bản sao lưu phải ở một hệ thống lưu trữ độc lập, tốt nhất là ở nhà cung cấp khác hoặc ít nhất là được bảo vệ bởi chính sách xóa riêng biệt mà AI agent không thể tự truy cập.

Mọi hành động thay đổi dữ liệu quan trọng phải có bước xác nhận thủ công

Bất kỳ lệnh nào liên quan đến xóa, ghi đè hoặc thay đổi không thể đảo ngược phải yêu cầu con người xác nhận, tuyệt đối không được để AI agent tự quyết định. Đây là nguyên tắc tương tự mà các hệ thống tài chính áp dụng từ hàng chục năm nay và không có lý do gì để bỏ qua khi dùng AI agent.

Thiết lập môi trường thử nghiệm thực sự tách biệt

Môi trường thử nghiệm (staging) phải hoàn toàn tách rời khỏi hệ thống đang hoạt động (production) về mặt credentials, token và quyền truy cập không chỉ mỗi mặt dữ liệu. Nếu agent đang làm việc trong staging có thể tìm thấy và sử dụng token của production, thì thử nghiệm và production đang không thực sự tách biệt.

Câu hỏi thực sự mà vụ PocketOS đặt ra

Câu hỏi không phải là "AI có nên được trao quyền làm việc tự động không?" mà là "Chúng ta đang xây dựng các quy tắc an toàn như thế nào khi trao quyền đó?" Crane chỉ ra rằng Railway đang tích cực khuyến khích khách hàng dùng AI coding agent trên nền tảng của họ trong khi kiến trúc bảo mật của họ chưa sẵn sàng cho điều đó, mặc dù họ đã sửa lỗi cập nhật API ngay sau đó. Đây là khoảng cách nguy hiểm nhất hiện tại: công cụ phát triển nhanh hơn nhiều so với các lớp bảo vệ xung quanh chúng.

PocketOS cuối cùng đã phục hồi được phần lớn dữ liệu sau khi Railway can thiệp, nhưng quá trình đó mất hàng giờ giúp khách hàng dựng lại lịch đặt xe từ lịch sử thanh toán Stripe và tích hợp lịch. Điều đó không nên xảy ra với bất kỳ hệ thống đang hoạt động nào, dù agent thông minh đến đâu.

Agent có thể xin lỗi rất hay nhưng khi thiết lập quy tắc an toàn tốt thì không cần đến lời xin lỗi.
Thảo luận (0)

Đăng nhập để tham gia thảo luận.

Chưa có bình luận nào. Hãy là người đầu tiên!

Các bài viết liên quan

MCP là gì? Vì sao cả ngành AI đang đua nhau tích hợp

Tháng 3/2026, SDK của Model Context Protocol (MCP) chạm mốc 97 triệu lượt tải mỗi tháng, tăng gấp 970 lần chỉ sau 18 tháng ra mắt. OpenAI, Google DeepMind, Microsoft, AWS đều đã lần lượt tích hợp MCP vào sản phẩm của mình, và đến tháng 12/2025, chính Anthropic quyết định trao MCP cho Linux Foundation quản lý để nó trở thành chuẩn chung của cả ngành. Đây không còn là một dự án nội bộ của Anthropic mà là hạ tầng mà gần như toàn bộ ngành AI đang xây dựng dựa trên đó. MCP là gì? Model Context Protocol (MCP) là một giao thức mở do Anthropic công bố vào tháng 11/2024, giúp các AI model kết nối với dữ liệu và công cụ bên ngoài như Gmail, GitHub, Notion, database nội bộ, theo một chuẩn chung duy nhất thay vì mỗi bên tự viết tích hợp riêng. Cách dễ hình dung nhất là so sánh MCP với cổng USB-C. Trước khi có USB-C, mỗi thiết bị dùng một loại cổng sạc riêng và bạn phải mang theo cả đống dây cáp khác nhau cực kì rối rắm rồi USB-C xuất hiện giúp mọi thiết bị chỉ cần duy nhất một loại cổng có thể cắm vào bất kỳ đâu. MCP làm điều tương tự cho AI mang đến sự tiện lợi khi có thể kết nối với bất kỳ công cụ, nền tảng hay nguồn dữ liệu nào hỗ trợ chuẩn này, không cần code riêng cho từng cặp model và công cụ hay nền tảng. MCP hoạt động như thế nào? Kiến trúc host-client-server MCP không chỉ có hai lớp client-server đơn giản như mọi người vẫn nghĩ mà thực chất chia làm ba vai trò rõ ràng: Host: ứng dụng AI mà bạn dùng trực tiếp, ví dụ Claude Desktop, Claude Code, hay một IDE có tích hợp AI. Host giống như bộ não đóng vai trò điều phối trung tâm, quản lý quyền truy cập và chính sách bảo mật cho toàn bộ phiên làm việc. Client: thành phần do host khởi tạo, mỗi client kết nối với đúng một server và xử lý giao tiếp hai chiều giữa host và server đó. Server: là máy chủ kết nối trực tiếp với công cụ, nền tảng gốc (như Google Drive, Slack, Email, Calendar, Database). Server đóng vai trò bóc tách và cung cấp khả năng thực thi cho AI. Khi bạn kết nối 3 MCP server trong Claude Desktop, thực chất Host đang quản lý 3 client riêng biệt, mỗi client nói chuyện với đúng một server. Ba thành phần chính: tools, resources, prompts Tools: các hàm mà AI có thể gọi để thực hiện hành động, ví dụ send_email, create_issue, search_database. Resources: dữ liệu mà AI có thể đọc bổ sung ngữ cảnh cho LLM, đó có thể là file hoặc bản ghi hoặc nội dung một trang Notion hay cơ sở dữ liệu. Prompts: các câu lệnh dựng sẵn mà server cung cấp để hướng dẫn AI dùng tool đúng cách cho một tác vụ cụ thể hoặc có thể giúp người dùng kích hoạt nhanh hơn. Một ví dụ cụ thể Giả sử bạn hỏi Claude "email nào gần đây nhắc đến hợp đồng ABC?". Claude Desktop (Host) khởi tạo client kết nối tới MCP server của Gmail. Server này gọi Gmail API để tìm email liên quan, sau đó trả kết quả về theo format MCP chuẩn. Claude đọc kết quả đó và trả lời bạn bằng ngôn ngữ tự nhiên. Với quy trình nhiều bước hơn, ví dụ tóm tắt một video YouTube rồi lưu bản tóm tắt vào Google Drive, Claude sẽ lần lượt gọi hai MCP server khác nhau trong cùng một tác vụ, hoàn toàn không cần bạn tự chuyển đổi qua lại giữa các công cụ. MCP không tự nó tạo ra sự thông minh, thực chất nó chỉ là một lớp kết nối chuẩn hóa. Chất lượng câu trả lời vẫn phụ thuộc vào model đứng sau và vào cách MCP server đó thực hiện công cụ của mình. MCP khác gì so với API hay plugin truyền thống? Trước khi có MCP, nếu bạn muốn 5 AI model khác nhau (Claude, GPT, Gemini, Llama, Mistral) đều kết nối được với 5 dịch vụ (Gmail, Slack, GitHub, Notion, Jira), về lý thuyết bạn cần viết tới 25 bộ tích hợp riêng biệt, mỗi cặp model-dịch vụ một kiểu. Đây gọi là bài toán N×M. MCP giải quyết bài toán này bằng cách chuẩn hóa giao thức ở giữa, ở đây chúng ta chỉ cần viết một MCP server duy nhất và mọi AI model hỗ trợ MCP đều dùng được ngay. Số lượng tích hợp cần thiết giảm từ N×M xuống còn N+M. Plugin truyền thống: mỗi nền tảng AI có hệ plugin riêng (ví dụ GPT Actions, Claude tool use tự viết), không dùng chéo được giữa các nền tảng. API truyền thống: developer phải tự đọc tài liệu, tự viết code riêng gọi API, tự xử lý authentication cho từng dịch vụ tất nhiên giao tiếp thường chỉ một chiều theo yêu cầu-phản hồi cố định. MCP: đã là một chuẩn chung, tức là chỉ cần viết một lần có thể dùng được trên toàn bộ hệ sinh thái AI hỗ trợ MCP, đồng thời hỗ trợ giao tiếp hai chiều liên tục, tức AI vừa có thể kéo dữ liệu về (đọc lịch làm việc) vừa đẩy hành động ra (tạo sự kiện mới) trong cùng một phiên làm việc. Khi nào API truyền thống vẫn tốt hơn MCP? MCP linh hoạt không có nghĩa nó luôn là lựa chọn hàng đầu. Với những hệ thống cần độ chính xác tuyệt đối và hành vi có thể dự đoán trước, ví dụ nghiệp vụ ngân hàng như kiểm tra số dư hay chuyển khoản, API truyền thống với luồng xử lý cố định, được kiểm soát chặt từng bước vẫn là lựa chọn an toàn hơn. MCP phù hợp nhất khi bạn cần AI tự quyết định gọi tool nào, theo thứ tự nào, dựa trên ngữ cảnh hội thoại, chứ không phải cho các giao dịch đòi hỏi quy trình cứng và kiểm soát rủi ro nghiêm ngặt. Vì sao cả ngành AI đang đua nhau làm MCP? Tốc độ áp dụng MCP là điều hiếm thấy với một chuẩn công nghệ mới. Tháng 3/2025, OpenAI chính thức hỗ trợ MCP trong Agents SDK và ChatGPT desktop, dù đây là đối thủ trực tiếp của Anthropic. Giữa năm 2025, Google DeepMind tích hợp MCP vào Gemini API. Microsoft đưa MCP support vào VS Code Copilot đạt bản GA vào tháng 7/2025. Bước ngoặt lớn nhất diễn ra ngày 9/12/2025, khi Anthropic trao MCP cho Agentic AI Foundation (AAIF) thuộc Linux Foundation quản lý. OpenAI, Block cùng đứng ra làm đồng sáng lập, còn AWS, Google, Microsoft, Cloudflare, Bloomberg tham gia với vai trò thành viên platinum. Đây là tín hiệu rõ ràng nhất rằng MCP không còn là sân nhà của Anthropic nữa mà trở thành hạ tầng chung mà cả các đối thủ cạnh tranh cũng muốn cùng xây dựng thay vì tự làm bản riêng. Ngay cả các doanh nghiệp phần cứng cũng không đứng ngoài cuộc chơi và cũng đã tham gia mở cổng MCP cho các thiết bị của mình. Ví dụ như các hãng đồng hồ thông minh, máy đo nhịp tim. Đến tháng 7/2026, MCP tung ra bản cập nhật spec lớn nhất từ trước tới giờ (2026-07-28), với protocol core chuyển sang stateless, thêm Extensions framework và cơ chế authorization theo chuẩn OAuth/OpenID Connect, giải quyết những rào cản cuối cùng khiến doanh nghiệp lớn còn e ngại khi triển khai production. Tính đến năm 2026, hơn 10.000 MCP server công khai đang chạy thực tế, và 28% doanh nghiệp Fortune 500 đã triển khai MCP server của riêng mình. Một chỉ dấu đáng chú ý: OpenAI đã khai tử Assistants API độc quyền của chính mình để chuyển hẳn sang MCP, với deadline ngừng hỗ trợ vào giữa 2026. Khi đối thủ cạnh tranh trực tiếp chọn bỏ chuẩn riêng để dùng chuẩn mở của Anthropic, đó là bằng chứng thị trường rõ ràng hơn bất kỳ tuyên bố nào. Ứng dụng thực tế: dùng MCP với Claude như thế nào? Với người dùng Claude.ai hoặc Claude Desktop, kết nối MCP server không đòi hỏi biết code. Vào Settings → Extensions, bạn sẽ thấy danh sách MCP server có sẵn (Google Drive, Notion, Slack, GitHub, Asana...) hoặc có thể thêm server tùy chỉnh bằng URL. Sau khi kết nối, Claude tự động biết khi nào cần gọi tool nào dựa trên câu hỏi của bạn. Một vài use case cụ thể mà mình dùng hàng ngày cho công việc biên tập 4AIVN: Claude + Google Drive MCP: hỏi trực tiếp "tìm file outline bài về Gemini 3.7 tuần trước" thay vì tự mở Drive tìm thủ công. Claude + GitHub MCP: kiểm tra pull request, đọc issue mà không cần rời khỏi cửa sổ chat. Claude + Notion MCP: cập nhật database content calendar ngay trong lúc đang trao đổi ý tưởng bài viết. Mỗi MCP server bạn kết nối đều được cấp quyền đọc/ghi vào dữ liệu thật của bạn. Trước khi bật một server lạ, kiểm tra kỹ nó do ai phát triển và nó xin quyền truy cập những gì, đặc biệt với server không nằm trong danh sách chính thức. MCP chắc chắn sẽ còn phát triển hơn nữa Điều đáng chú ý nhất về MCP không phải bản thân giao thức, mà tốc độ nó đang trở thành tiêu chuẩn ngầm định khi người dùng chọn công cụ AI. Giống cách người mua laptop giờ mặc định hỏi "có cổng USB-C không", trong 1-2 năm tới, câu hỏi “công cụ này có MCP server không" nhiều khả năng sẽ trở thành tiêu chí đánh giá bất kỳ SaaS hay thiết bị nào, không riêng gì phần mềm AI. Đây không còn là cuộc chơi riêng của OpenAI, Google hay Anthropic, mà đã lan tới cả các nào muốn tích hợp AI, doanh nghiệp nào chưa có MCP, dù sản phẩm tốt đến đâu, cũng đang tự đặt mình vào thế bất lợi khi người dùng ngày càng quen với việc hỏi thẳng AI thay vì tự mở app tra cứu. Phần này đối với các công ty vừa và nhỏ, kể cả ở Việt Nam, đây thực ra là cơ hội nhiều hơn là áp lực. Viết một MCP server không đòi hỏi hạ tầng khổng lồ như tự build một AI model, chỉ cần bọc lớp API sẵn có theo đúng chuẩn MCP là đủ để sản phẩm "nói chuyện" được với Claude, ChatGPT hay bất kỳ AI client nào hỗ trợ giao thức này. Ai làm trước, người đó có lợi thế trong giai đoạn người dùng vẫn còn đang hình thành thói quen.

Nam
21 thg 8, 2026
AI có thể lên kế hoạch tập luyện cá nhân hóa nhờ MCP

Chuẩn kết nối MCP (Model Context Protocol) do Anthropic phát triển đã lan rộng đến mức các nhà sản xuất thiết bị sức khỏe và đồng hồ thể thao thông minh buộc phải nhanh chóng nhập cuộc. Đúng như kỳ vọng từ cộng đồng công nghệ, Strava đã tung ra trình kết nối MCP chính thức đầu tiên cho giới chạy bộ và đạp xe. Chỉ chưa đầy một tháng sau, COROS cũng công bố bản thử nghiệm MCP beta để tối ưu khả năng tương tác với AI. Trong khi đó, dù ông lớn Garmin chưa chính thức đưa ra câu trả lời, làn sóng giải pháp MCP do cộng đồng lập trình viên tự phát triển đã chứng minh việc các thương hiệu tích hợp AI hai chiều chỉ còn là vấn đề thời gian.MCP là gì và vì sao thiết bị tập luyện đang chạy đua tích hợpMCP (Model Context Protocol) là một giao thức mở cho phép các mô hình ngôn ngữ lớn (LLM) như Claude, ChatGPT hay Gemini truy cập trực tiếp vào nguồn dữ liệu và công cụ bên ngoài theo thời gian thực. Thay vì chỉ đưa ra lời khuyên chung chung dựa trên văn bản nhập vào, AI có thể đọc hiểu toàn bộ lịch sử vận động của từng cá nhân.Đối với người tập luyện thể thao, thay vì phải mở ứng dụng, tự lọc biểu đồ nhịp tim và so sánh chỉ số thủ công, bạn chỉ cần hỏi thẳng AI: "Tuần này training load của tôi tăng hay giảm so với tuần trước?" hoặc "Tốc độ chạy bài Easy Run của tôi đã tối ưu cho việc phục hồi chưa?". AI sẽ đưa ra phản hồi chính xác bám sát số liệu cá nhân, giống như bạn đang đồng hành cùng một huấn luyện viên thể lực chuyên nghiệp 24/7.Strava MCP: Tiên phong mở rộng hệ sinh thái và siết chặt APICuộc đua MCP trong mảng thiết bị đeo bắt đầu bùng nổ từ ngày 1/6/2026 khi Strava ra mắt MCP chỉ đọc chính thức dành cho người dùng đăng ký trả phí. Thông qua cơ chế xác thực OAuth an toàn, các mô hình AI có thể truy xuất dữ liệu hoạt động, bản đồ GPS, độ dốc và biểu đồ công suất (power meters).Nhờ hỗ trợ chuẩn kết nối MCP mở, Strava MCP tương thích hoàn hảo với các công cụ hàng đầu từ Anthropic như Claude Cowork và Claude Code. Đáng chú ý, cùng thời điểm ra mắt MCP, Strava cũng tiến hành siết chặt chính sách API đối với các bên thứ ba: áp dụng mức phí hàng tháng và đặt giới hạn 90 ngày cho một số endpoint, nhằm ngăn chặn các công ty AI khai thác dữ liệu người dùng Strava mà không đóng góp doanh thu.MCP của Strava hiện vận hành hoàn toàn ở chế độ Read-Only (Chỉ đọc) để đảm bảo an toàn thông tin. Điều này nghĩa là AI có thể phân tích số liệu nhưng không thể chỉnh sửa, xóa hay tự ý tạo buổi tập mới trong tài khoản của bạn.Coros MCP beta: Kết nối nhanh nhưng dữ liệu còn hạn chếKhông chịu đứng ngoài cuộc chơi, COROS đã phát hành MCP chính thức (bản Beta) từ tháng 5/2026, hỗ trợ kết nối trực tiếp tài khoản COROS với Claude và ChatGPT. Quy trình thiết lập khá dễ dàng: người dùng chỉ cần sao chép liên kết MCP theo từng khu vực (dạng https://mcp.coros.com/mcp), dán vào phần Connector của Claude hoặc Developer Mode trên ChatGPT và hoàn tất xác thực.Mặc dù giúp kết nối dữ liệu nhanh chóng, Coros MCP hiện tại vẫn bộc lộ một số hạn chế nhất định:Độ chi tiết dữ liệu: Chỉ trả về số liệu tổng hợp theo từng buổi tập (workout summary), chưa hỗ trợ dữ liệu chi tiết theo từng lap (hiệp) hay thời gian thực theo từng giây.Quyền hạn: Hoạt động hoàn toàn ở chế độ Read-Only, không thể khởi tạo bài tập hay đẩy giáo án vào đồng hồ.Nền tảng hỗ trợ: Người dùng ChatGPT cần có tài khoản trả phí mới có thể sử dụng MCP. Trong khi đó, Gemini trên giao diện Web chưa hỗ trợ connector MCP tùy chỉnh, bắt buộc người dùng phải thao tác qua Gemini CLI trong terminal.Garmin garmin_mcp: Giải pháp cộng đồng với 110 tools mạnh mẽGarmin – hãng sở hữu thị phần đồng hồ thể thao lớn nhất hiện nay – vẫn chưa phát hành bất kỳ trình kết nối MCP chính thức nào. Tuy nhiên, khoảng trống này đã nhanh chóng được lấp đầy bởi cộng đồng mã nguồn mở với dự án garmin_mcp do lập trình viên Taxuspt phát triển trên GitHub.Dự án garmin_mcp trên GitHub đã đạt hơn 1.000 stars và 324 forks nhờ tích hợp hơn 110 công cụ (tools), bao phủ gần 90% thư viện python-garminconnect. Với garmin_mcp, người dùng có thể thực hiện những yêu cầu phân tích chuyên sâu mà cả Strava lẫn COROS chưa hỗ trợ:Yêu cầu Claude phân tích phân bổ vùng công suất (power zones) của bài đạp xe gần nhất.So sánh biến thiên các chỉ số thể lực nâng cao như CTL (Chronic Training Load), ATL (Acute Training Load) và TSB (Training Stress Balance) trong 6 tuần gần nhất.Tự động khởi tạo bài tập chạy biến tốc (walk-run interval) và đồng bộ trực tiếp lịch tập vào đồng hồ Garmin Connect – tính năng ghi dữ liệu vượt trội so với các bản MCP chỉ đọc.Vì garmin_mcp là dự án do cộng đồng phát triển, người dùng phải xác thực email và mật khẩu tài khoản Garmin Connect thông qua thư viện bên thứ ba. Bạn nên cân nhắc kỹ về vấn đề an toàn thông tin trước khi cung cấp thông tin đăng nhập cá nhân.Thực tế cho thấy vào tháng 3/2026, Garmin đã bất ngờ thay đổi phương thức xác thực API khiến hai thư viện phổ biến là garth và python-garminconnect bị gián đoạn hoạt động, trong đó garth bị ngừng phát triển. Điều này phản ánh rủi ro lớn nhất của các giải pháp MCP không chính thức: chúng phụ thuộc hoàn toàn vào các endpoint chưa công khai và có thể bị lỗi bất kỳ lúc nào nếu Garmin thay đổi hệ thống.So sánh nhanh ba hướng kết nối của Strava, Coros và GarminDưới đây là bảng tổng hợp giúp bạn có cái nhìn tổng quan về các phương án kết nối MCP hiện nay:Strava MCP (Chính thức): Chế độ Read-Only | Đăng ký trả phí | Dữ liệu hoạt động, GPS, công suất | Bảo mật OAuth cao | Không có dữ liệu giấc ngủ, HRV hay phục hồi.Coros MCP (Chính thức Beta): Chế độ Read-Only | Tài khoản AI trả phí | Dữ liệu tổng hợp buổi tập | Dễ thiết lập qua URL | Chưa có dữ liệu chia từng hiệp (lap) hay từng giây.Garmin garmin_mcp (Cộng đồng): Đọc & Ghi (Read & Write) | Mã nguồn mở | 110+ tools, phân tích CTL/ATL/TSB, tạo giáo án | Tính năng mạnh nhất | Nguy cơ gãy API và rủi ro mật khẩu tài khoản.Hướng dẫn thiết lập MCP phù hợp cho thiết bị bạn đang cóNếu bạn đang sử dụng Strava hoặc Coros, việc trải nghiệm vô cùng đơn giản: chỉ cần truy cập phần Tùy chỉnh Trình kết nối trên Claude.ai (hoặc bật Developer Mode trên ChatGPT), dán liên kết MCP chính thức và tiến hành xác thực tài khoản.Đối với người dùng Garmin muốn trải nghiệm sức mạnh AI ngay lập tức, lựa chọn tối ưu nhất là cài đặt extension garmin-mcp.dxt của Taxuspt trên Claude Desktop. Bạn chỉ cần xác thực một lần duy nhất bằng lệnh garmin-mcp-auth để lưu mã OAuth Token bảo mật, sau đó thoải mái trò chuyện với AI mà không cần nhập lại mật khẩu cho các lần sử dụng tiếp theo. Đây chắc chắn là giải pháp chuyển tiếp tuyệt vời trong khi chờ đợi Garmin chính thức công bố chuẩn MCP của riêng mình.

Liên
19 thg 8, 2026
Claude Opus 5 ra mắt với sức mạnh áp sát Fable 5

Anthropic vừa ra mắt Claude Opus 5 với mức giá giữ nguyên như Opus 4.8 nhưng chất lượng trả lời được nâng lên gần bằng Fable 5, model đắt gấp đôi. Nói cách khác, với mức giá bằng một nửa Fable 5 mà hiệu năng lại áp sát, phần lớn người dùng nhiều khả năng sẽ chọn Opus 5 làm model mặc định, chỉ giữ Fable 5 cho số ít tác vụ thật sự cần đến giới hạn cao nhất. Claude Opus 5 mang đến những nâng cấp nào? Theo thông báo ra mắt của Anthropic, Claude Opus 5 là model Opus mạnh nhất tính đến nay và là đại diện đầu tiên của dòng Opus thuộc thế hệ Claude 5. Anthropic mô tả đây là model chủ động, biết suy nghĩ sâu và tiến gần trí tuệ cấp cao nhất của Claude Fable 5 trong nhiều lĩnh vực, nhưng chỉ tốn một nửa chi phí token. Model có mã API claude-opus-5, context mặc định và tối đa 1 triệu token, tương tự Opus 4.8 và Fable 5, cùng giới hạn đầu ra 128.000 token và chế độ thinking được bật mặc định. Nó đã trở thành model mặc định trên Claude Max và là model mạnh nhất khả dụng trên Claude Pro, đồng thời có mặt trên Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry và cả GitHub Copilot. Vì sao nhiều người sẽ chọn Opus 5 thay vì Fable 5? Câu trả lời không chỉ nằm ở con số giá. Có bốn lý do khiến Opus 5 nhiều khả năng trở thành lựa chọn mặc định cho công việc hằng ngày, trong khi Fable 5 lùi về vai trò công cụ chuyên dụng cho số ít trường hợp đặc biệt. Thắng nhiều hơn thua trên các bài kiểm tra thực tế Trên Frontier-Bench v0.1, bài kiểm tra coding tự động của chính Anthropic, Opus 5 đạt 43,3% trong khi Fable 5 chỉ đạt 33,7%, một khoảng cách gần 10 điểm nghiêng hẳn về Opus 5. Trên CursorBench 3.2 ở mức effort tối đa, Opus 5 đạt khoảng 70,1%, thua Fable 5 chưa tới nửa điểm phần trăm nhưng chi phí chỉ bằng một nửa. Tính chung trên các bài kiểm tra mà cả hai model đều có số liệu, Opus 5 thắng nhiều hơn thua và phần thắng thường lớn hơn phần thua. Cách kiểm chứng nhanh nhất: chạy cùng một tác vụ trên cả hai model ở effort tương đương, rồi so sánh chất lượng đầu ra thay vì chỉ nhìn benchmark được công bố. Không bị ép giữ dữ liệu 30 ngày Fable 5 và Mythos 5 thuộc nhóm Covered Models, bắt buộc lưu giữ prompt và kết quả trong 30 ngày để phục vụ công tác an toàn, đồng thời không hỗ trợ zero data retention (ZDR) trên bất kỳ nền tảng nào, kể cả khi tổ chức đã có thỏa thuận ZDR từ trước. Ngược lại, Opus 5 vẫn vận hành được dưới ZDR như Opus 4.8. Với các đội ngũ xử lý dữ liệu pháp lý, y tế hoặc tài chính, riêng điểm này đã đủ để loại Fable 5 khỏi danh sách lựa chọn mà không cần so hiệu năng. Ít bị gián đoạn bởi bộ lọc an toàn Anthropic cho biết bộ phân loại an ninh mạng của Opus 5 can thiệp ít hơn khoảng 85% so với Fable 5. Với các coding agent chạy nhiều giờ hoặc qua đêm, việc bị chặn giữa chừng vì request chạm ngưỡng an toàn là rủi ro thực sự làm gián đoạn quy trình, và Opus 5 giảm đáng kể tần suất đó. Effort điều chỉnh được, ngân sách dễ đoán hơn Opus 5 hỗ trợ adaptive thinking với effort từ thấp đến tối đa. Mức thấp hoặc trung bình phù hợp cho phản hồi nhanh và khối lượng lớn, còn mức cao hoặc tối đa dành cho coding phức tạp, nghiên cứu sâu và quy trình nhiều bước. Vì phải trả tiền theo effort đã chọn thay vì bị khóa vào một mức giá cố định như Fable 5, đội ngũ có thể tối ưu ngân sách theo từng loại tác vụ thay vì trả giá cao nhất cho mọi request. Cảm nhận ban đầu sau khi dùng thử Opus 5 Sau khi dùng thử Opus 5 cho công việc viết lách và xử lý code hằng ngày, cảm nhận rõ nhất là model này thông minh hơn hẳn Opus 4.8, đặc biệt ở khả năng hiểu ý đồ ngay từ lần yêu cầu đầu tiên mà không cần giải thích lại nhiều lần. Với các tác vụ như tóm tắt tài liệu dài, viết code có logic rẽ nhánh phức tạp hoặc lên kế hoạch nhiều bước, Opus 5 xử lý mượt và ít khi đi lạc đề như bản cũ thường gặp. So với Fable 5 thì vẫn có khoảng cách, dù không lớn như tưởng tượng. Ở những tác vụ đòi hỏi suy luận sâu hoặc phải tự chủ qua nhiều bước liên tiếp mà không có ai can thiệp, Fable 5 vẫn xử lý chắc tay và ít sai sót hơn một chút. Nhưng với phần lớn công việc hằng ngày, mức chênh lệch đó khó nhận ra nếu không đặt hai model cạnh nhau để so sánh trực tiếp. Nếu bạn đang dùng Opus 4.8, đây là thời điểm hợp lý để nâng cấp. Còn nếu đang cân nhắc giữa Opus 5 và Fable 5 cho công việc thông thường, Opus 5 gần như đủ dùng mà không cần trả thêm tiền. Khi nào Fable 5 vẫn là lựa chọn đúng? Fable 5 vẫn giữ được lợi thế ở đúng những chỗ khó nhất. Trên SWE-bench Pro, bộ kiểm tra dùng vấn đề GitHub có thật và được xem là thước đo khắt khe nhất cho công việc coding thực tế, Fable 5 đạt khoảng 80% trong khi Opus 5 đạt khoảng 79%, một khoảng cách nhỏ nhưng vẫn nghiêng về Fable 5. Fable 5 cũng là model duy nhất Anthropic định vị ở cấp Mythos, tức năng lực tổng thể cao hơn Opus theo thiết kế, và điều này thể hiện rõ ở các lĩnh vực chuyên sâu như phân tích y tế chuyên môn hoặc nghiên cứu tự chủ kéo dài nhiều ngày mà không có người giám sát. Nói cách khác, phần thắng của Opus 5 tập trung ở công việc coding và xử lý tri thức hằng ngày, còn lợi thế của Fable 5 nằm ở những bài toán khó nhất và các lĩnh vực đòi hỏi độ tin cậy tuyệt đối. Với đa số người dùng và đội ngũ nhỏ, những bài toán đó chiếm tỷ trọng rất nhỏ trong công việc thường ngày, nên khoản chênh lệch giá gấp đôi khó biện minh được, trừ khi công việc của bạn rơi đúng vào nhóm này. So sánh nhanh Opus 5 và Fable 5 Tiêu chíClaude Opus 5Claude Fable 5 Giá đầu vào5 USD/triệu token10 USD/triệu token Giá đầu ra25 USD/triệu token50 USD/triệu token Context1 triệu token1 triệu token Đầu ra tối đa128.000 token128.000 token Frontier-Bench v0.1 (coding agent)43,3%33,7% SWE-bench Pro (coding thực tế)~79%~80% Lưu giữ dữ liệuHỗ trợ zero data retentionBắt buộc lưu giữ 30 ngày, không có ZDR Tần suất chặn bởi bộ lọc an toànThấp hơn khoảng 85%Cao hơn Phù hợp nhấtCông việc hằng ngày, coding agent, dữ liệu nhạy cảmNghiên cứu khó, dự án tự chủ dài ngày, phân tích y tế chuyên sâu Vậy Opus 5 có thật sự đọ được với GPT-5.6? Trên giấy tờ, câu trả lời là có, nhưng không phải toàn diện. Opus 5 dẫn trước GPT-5.6 Sol ở khả năng suy luận với tình huống mới, thao tác máy tính và phần lớn bài kiểm tra coding công khai, trong khi GPT-5.6 Sol vẫn nhỉnh hơn ở một số bài kiểm tra thao tác dòng lệnh và tìm kiếm thông tin. Không bên nào thắng tuyệt đối, nhưng lần đầu tiên một model tầm giá trung của Anthropic đứng ngang hàng, thậm chí nhỉnh hơn ở nhiều mặt so với model đầu bảng của OpenAI. Câu hỏi đáng quan tâm hơn không phải model nào mạnh hơn mà là model nào thực sự phù hợp với bạn. Nếu công việc hằng ngày xoay quanh code, tài liệu dài và tác vụ nhiều bước, Opus 5 đang là lựa chọn hợp lý cả về giá lẫn chất lượng. Còn nếu bạn đã quen với hệ sinh thái OpenAI hoặc cần đúng thế mạnh của GPT-5.6, chi phí chuyển đổi có thể không đáng để thay đổi. Cách trả lời chắc chắn nhất vẫn là tự chạy thử cùng một việc trên cả hai, vì bảng benchmark không phải lúc nào cũng phản ánh đúng trải nghiệm thật.

Nam
25 thg 7, 2026
Hướng dẫn dùng Codex tự động hóa Excel và Google Sheets

Tự động hóa báo cáo Excel và Google Sheets không còn là đặc quyền của các kỹ sư lập trình. Với sự phát triển vượt bậc của các mô hình AI như GPT thì bây giờ nhân viên văn phòng giờ đây có thể tự tạo ra các công cụ tự động hóa công việc chỉ bằng các câu lệnh đơn giản với Codex, giải phóng hàng giờ đồng hồ làm việc lặp đi lặp lại mỗi ngày. Vì sao công thức Excel và VBA không còn đủ Với những báo cáo lặp lại mỗi tuần hay các hàm tự động kết nối với mail, slack, zalo.., các phương pháp truyền thống như viết hàm Excel lồng nhau hay ghi macro VBA (Visual Basic for Applications) đòi hỏi kiến thức kỹ thuật nhất định và rất dễ vỡ khi cấu trúc file nguồn thay đổi dù chỉ một cột. Đây chính là khoảng trống mà OpenAI Codex lấp vào: bạn mô tả chính xác việc cần làm bằng ngôn ngữ tự nhiên, Codex sinh ra mã Python hoặc Google Apps Script hoàn chỉnh để thực thi trong vài giây. Codex không phải một sản phẩm duy nhất Điểm dễ gây nhầm lẫn là Codex hiện có thể sử dụng theo rất nhiều cách CLI chạy trong terminal, extension tích hợp trong các IDE như VS Code, Codex Web chạy trên cloud tại https://chatgpt.com/codex/cloud giành cho những lập trình viên và ai biết về code ngoài ra còn có ứng dụng desktop cho cả macOS lẫn Windows. Với dân văn phòng không rành dòng lệnh, cách dễ bắt đầu nhất là tải Codex desktop app về máy, ứng dụng cho phép quản lý nhiều agent cùng lúc ngay trên giao diện, không cần mở Terminal hay tự cấu hình API key, chỉ cần đăng nhập bằng tài khoản ChatGPT sẵn có. Một prompt mẫu sẽ như thế nào Bạn chỉ cần cung cấp cho Codex một câu prompt chi tiết như sau: "Hãy viết đoạn mã Python đọc tệp Excel 'sales_raw.xlsx', lọc ra các đơn hàng có trạng thái 'Completed', tính tổng doanh thu theo từng chi nhánh và xuất kết quả ra tệp 'bao_cao_doanh_thu.xlsx' với hàng tiêu đề được tô màu xanh dương đậm." Codex sẽ lập tức viết ra đoạn mã chuẩn mực, bạn chỉ việc chạy script và nhận về kết quả báo cáo hoàn hảo. Tự động hóa báo cáo Excel cục bộ với Python và Codex Với file Excel lưu trên máy, sự kết hợp giữa Codex và hai thư viện Python phổ biến là pandas cùng openpyxl đem lại tốc độ xử lý vượt trội. Pandas xử lý hàng trăm nghìn dòng dữ liệu chỉ trong vài giây, trong khi openpyxl đảm nhận việc định dạng ô tính, tô màu tiêu đề và chèn công thức đúng như ví dụ ở trên đã minh họa. Tự động hóa Google Sheets trên đám mây Khi công ty làm việc trên Google Sheets thay vì file Excel offline, thư viện Python gspread hoặc Google Apps Script là lựa chọn phù hợp hơn. Codex có thể viết mã kết nối trực tiếp với Google Sheets API thông qua Service Account (file JSON xác thực) để đọc và ghi dữ liệu liên tục mà không cần mở trình duyệt. Một luồng công việc mẫu Tự động kéo dữ liệu mới từ Google Form về bảng tính Tự động phân loại phản hồi khách hàng theo mức độ ưu tiên Tự động gửi email tổng hợp cho ban giám đốc vào 17:00 mỗi ngày Toàn bộ luồng này chạy nền, không cần ai chạm tay vào bàn phím sau khi đã thiết lập một lần. Quy trình 4 bước triển khai cho người không biết code Bước 1 - Chuẩn hóa dữ liệu đầu vào: đảm bảo file Excel hoặc Google Sheets có hàng tiêu đề rõ ràng, không merge ô tùy tiện. Bước 2 - Viết prompt rõ ràng cho Codex: nêu cụ thể tên file, tên cột dữ liệu, bước lọc/tính toán và định dạng đầu ra mong muốn. Bước 3 - Chạy thử và dán lỗi để AI tự sửa: nếu script báo lỗi, copy toàn bộ thông báo lỗi (traceback) dán lại cho Codex để nó tự chỉnh sửa. Bước 4 - Lập lịch chạy tự động: dùng Windows Task Scheduler (Windows) hoặc Cron job (macOS/Linux) để script tự chạy theo mốc giờ cố định. Rủi ro cần lường trước khi giao báo cáo cho AI Codex thông minh nhưng không miễn phí hoàn tuy nhiên các thao tác đơn giản với excel hoặc google sheets không làm mất quá nhiều quota cho nên nếu sử dụng ít thì hoàn toàn có thể dùng gói miễn phí còn nếu cần các tác vụ nặng hơn thì có thể cân nhắc mua gói Plus và Pro không nên chọn gói Go vì Codex làm việc ở gói này không khác gói miễn phí là bao. Tuyệt đối không dán mật khẩu hệ thống, dữ liệu tài chính hay thông tin khách hàng thật vào ô chat của công cụ AI công cộng. Khi nhờ Codex viết code, hãy thay bằng dữ liệu giả lập (dummy data) có cùng cấu trúc. Với các xác thực quan trọng như số tiền hay công thức tính thuế, đừng tin tuyệt đối vào code Codex sinh ra ngay từ lần đầu. Hãy đối soát kết quả trong 1-2 lần chạy đầu tiên để chắc chắn logic khớp với yêu cầu nghiệp vụ thực tế của công ty bạn. Tự động hóa báo cáo bằng Codex không biến bạn thành lập trình viên, và cũng không nên được xem là vậy. Giá trị thực sự nằm ở việc bạn hiểu rõ dữ liệu và quy trình của mình đủ để mô tả chính xác cho AI bởi phần viết code, Codex đã lo. Nếu công ty bạn có báo cáo lặp lại mỗi tuần, việc đáng làm ngay là chọn một báo cáo đơn giản nhất, thử viết prompt theo mẫu ở trên và chạy thử trong chính buổi làm việc hôm nay.

Nam
24 thg 8, 2026